

O Google DeepMind afirma que o Gemini 4 Argon atingiu 87% no benchmark de raciocínio físico ERQA (Embodied Reasoning QA, que mede a capacidade de resolver problemas espaciais em ambientes tridimensionais usando apenas raciocínio, sem ferramentas externas), superando todo outro modelo de fronteira, segundo publicação da empresa em seu blog nesta terça-feira (13).
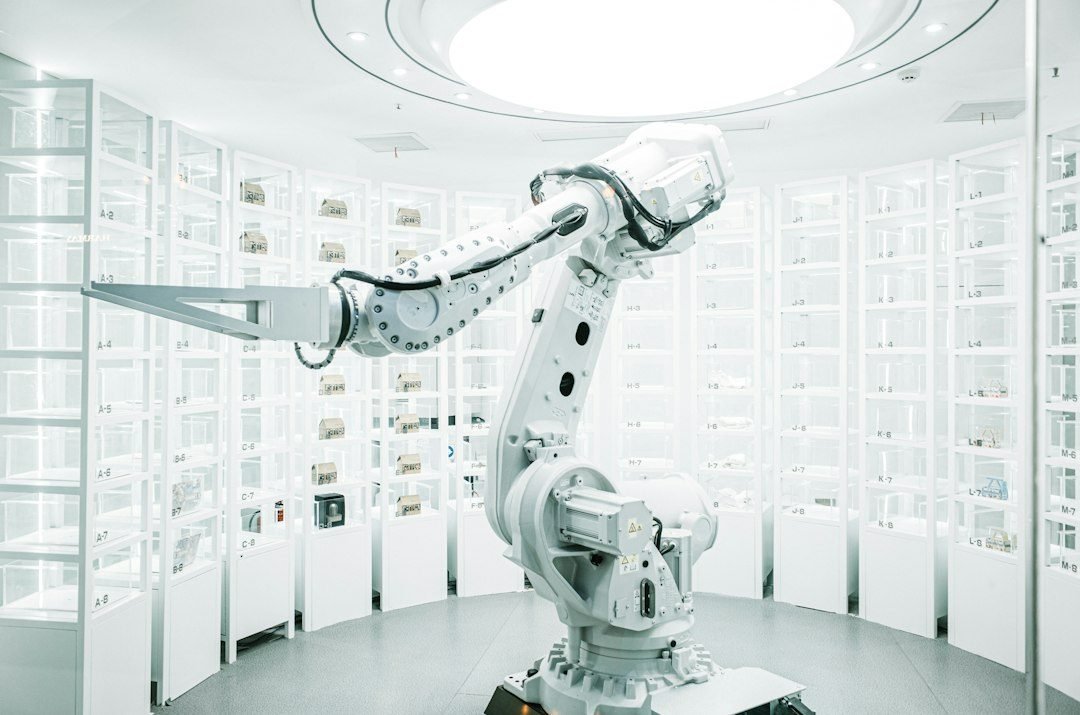
A empresa descreve o Argon como um "modelo de raciocínio físico de uso geral", aplicável a todas as etapas de um projeto de robótica, do planejamento ao controle direto de robôs. O mesmo modelo já estava liberado desde 13 de outubro para assinantes dos planos Google AI Pro e Ultra, como o Cortexplor noticiou; a novidade agora é essa aplicação específica à robótica, detalhada em uma série de demonstrações.
Robôs reais e simulados
Em um dos exemplos, segundo o Google, o Argon controlou um robô quadrúpede Boston Dynamics Spot — com pernas de 12 graus de liberdade e um braço de seis — para aprender a pisar no pedal de uma lixeira e jogar latas de refrigerante dentro dela. Antes de mover o robô físico, o modelo criou uma réplica digital do objeto no MuJoCo, um motor de física usado para simular movimentos, e testou a ação ali primeiro.
Em outro teste, a empresa afirma que o Argon controlou um braço robótico simples para endireitar uma caneca caída e colocar dentro dela um guardanapo amassado, raciocinando sobre a tarefa ao longo de várias etapas. Em um ambiente de simulação chamado Gemini Omni World Model, o modelo reorganizou peças de Scrabble espalhadas até formar a palavra "ARGON", ajustando seus próprios comandos a cada novo quadro de imagem, no que o Google chama de "ciclo visual fechado".
Aprende observando vídeo e cria suas próprias simulações
Segundo a empresa, o Argon também consegue observar um vídeo real de uma pessoa realizando uma tarefa manual, identificar os objetos envolvidos e transferir o movimento da mão humana para um robô humanoide bimanual com 76 graus de liberdade e mãos de cinco dedos. A partir de uma foto de um esboço feito à mão — um humanoide chamado Apollo 2 arremessando uma bola para derrubar uma pilha de caixas —, o modelo montou sozinho a simulação física, calculou a trajetória do arremesso, confirmou o resultado em um teste fechado e gerou um vídeo renderizado da cena, de acordo com o Google.
Em uma avaliação com um robô bimanual ALOHA 2 dobrando uma folha de papel em formato de raposa de origami ao longo de 136 segundos, o modelo identificou e classificou automaticamente cada etapa do movimento, incluindo falhas como pausas e perda de firmeza na pegada. Em outro teste, com doze bolas de sinuca idênticas — uma mais leve ou mais pesada que as demais —, o Argon operou dois braços robóticos Franka FR3 e uma balança para isolar a bola diferente usando no máximo três pesagens, guiando-se apenas por imagens de câmeras.
A empresa também usou o modelo para gerar dados sintéticos de treinamento: a partir de uma única foto de uma mesa real, o Argon construiu uma simulação calibrada, criou tarefas novas e produziu mais de 4.500 episódios simulados. Segundo o Google, esse treinamento elevou a taxa de sucesso de um robô físico em uma tarefa de 56% para 75% e reduziu o tempo de execução de 35 para 24 segundos.
Na prática
- O recurso foi anunciado direto pelo Google DeepMind; até a publicação desta matéria, nenhum outro veículo havia confirmado os resultados de forma independente.
- A empresa não informou data de disponibilidade geral, preço ou lista de parceiros para essa aplicação específica do Argon à robótica.
- O modelo usado na demonstração, o Gemini 4 Argon, está liberado desde 13 de outubro para assinantes dos planos Google AI Pro e Ultra no aplicativo Gemini, na Busca e na plataforma Antigravity.
- Os números de desempenho citados — 87% no benchmark ERQA e o salto de 56% para 75% na taxa de sucesso de uma tarefa robótica — vêm de testes internos do Google.